Por qué reconstruimos un modelo que ya iba por delante
Nuestros modelos anteriores estaban ajustados a fondo para el comercio electrónico, y ese ajuste funcionó.
Lo que seguía apareciendo, tanto en el comercio electrónico como en el ámbito postal, es la poca información con la que a menudo contamos. Un anuncio de comercio electrónico puede incluir un título descriptivo, una categoría y algún dato sobre el material del artículo. Muchos lo hacen. Muchos otros son solo una marca y un nombre de producto, y un anuncio llamado Summit Ridge Mid no le dice si se trata de una bota de montaña, una mochila o una chaqueta, y mucho menos de qué está hecho.
El ámbito postal es donde esto se vuelve más difícil. Zonos gestiona la gran mayoría de todos los envíos postales que entran en Estados Unidos, y allí un paquete suele describirse con dos o tres palabras, escritas en un formulario aduanero por la persona que preparó la caja, sin nada más que lo respalde.
Para eso lo reconstruimos: para los artículos cuya descripción no dice mucho, sea cual sea el canal por el que lleguen.
“Camiseta” puede corresponder a más de 16 códigos SA, pero ¿a cuál?
Supongamos que una declaración dice t-shirt y nada más. Podría corresponder a cualquiera de más de 16 códigos SA. El correcto depende del material de la camiseta, del público para el que está confeccionada y de cómo se tejió, y el arancel adeudado cambia con cada una de esas respuestas. Solo el algodón y las fibras sintéticas ya se ubican en subpartidas distintas con tipos considerablemente diferentes.
Multiplique eso por un catálogo. Kid-Silk Mohair 25g es el tipo de título que vemos todo el día, y aun así tiene que traducirse en una sola línea del arancel aduanero.
En esos casos más complicados nos hemos centrado en esta ocasión. Los artículos bien descritos reciben la misma atención; simplemente es menos probable que confundan a un clasificador.
Cómo lo medimos
Medimos el nuevo modelo como querríamos que un proveedor lo midiera para nosotros: con tráfico real, no con un conjunto de pruebas elegido por nosotros. Utilizamos dos semanas de solicitudes de clasificación que pasaron por nuestra plataforma, es decir, los títulos y descripciones que nuestros clientes envían realmente, incluidos los que apenas son una descripción.
En ese tráfico, el nuevo modelo comete un 29,4 % menos de errores que el modelo al que reemplaza.
Se trata de un modelo nuevo, no de una versión reajustada del anterior. Reconstruimos el corpus del que aprende y lo entrenamos con resoluciones aduaneras oficiales junto con millones de anuncios parcialmente descritos que nuestro clasificador ve cada día.
Frente a un competidor, con los mismos envíos
Comparar un modelo con su propio modelo anterior solo aporta hasta cierto punto. Tomamos 1.000 envíos reales y los procesamos con tres sistemas: el clasificador de un competidor líder, el modelo que Classify Zonos AI utiliza hoy y el nuevo. Todos los envíos se evaluaron de la misma manera.
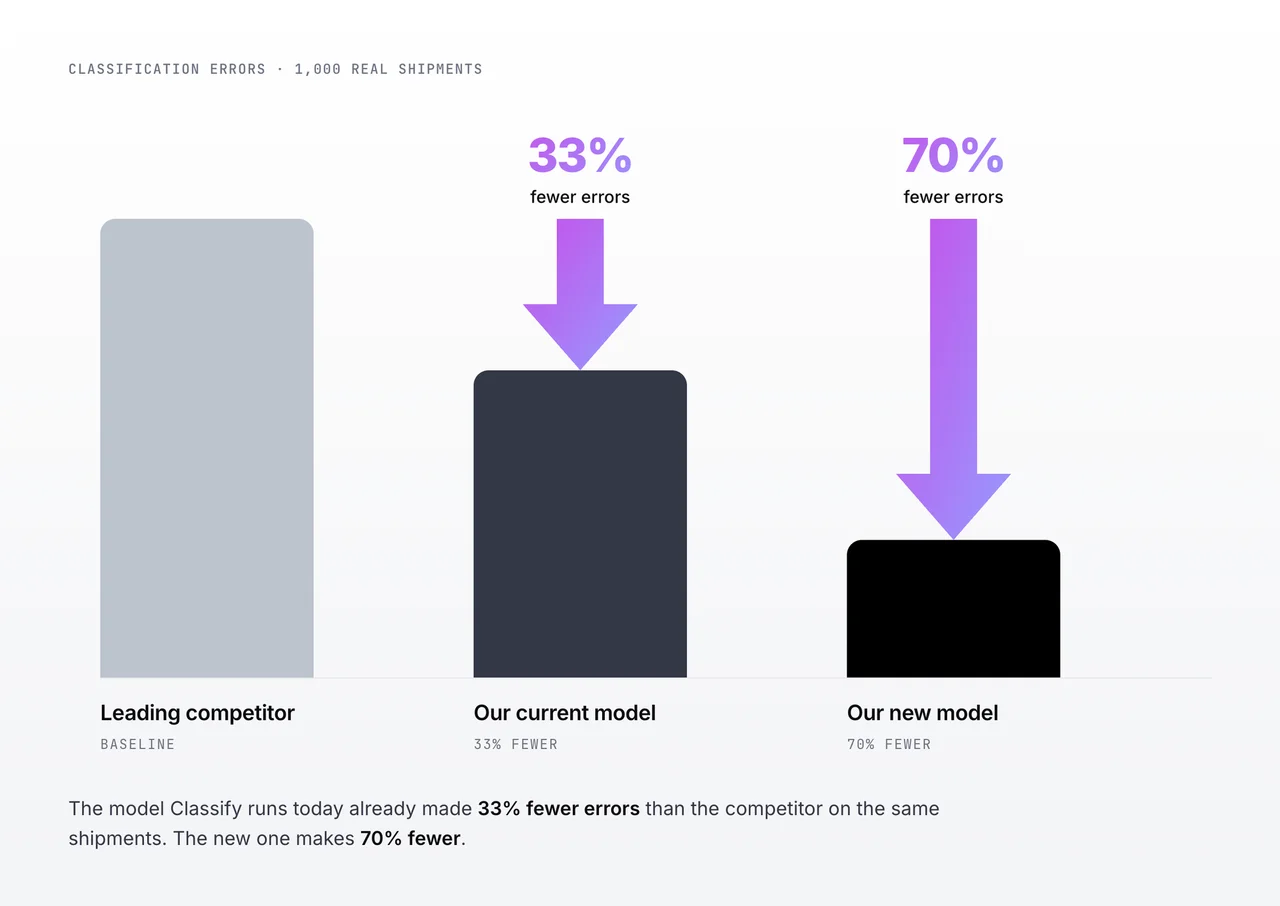
El modelo que Classify Zonos AI utiliza hoy ya cometía un 33 % menos de errores que el competidor. El nuevo comete un 70 % menos.
Algunos errores cuestan más que otros
No todos los errores de clasificación tienen el mismo coste. Si un par de calcetines se clasifica a una subpartida de distancia de donde corresponde, el arancel adeudado suele ser parecido y nadie lo nota. Si esos mismos calcetines acaban en un capítulo completamente distinto del arancel aduanero, registrados como algo que no son, el arancel no se parece en absoluto. Esos son los que acaban convirtiéndose en una factura inesperada más adelante, y son una parte importante de por qué reconstruimos el modelo.
Qué significa esto para usted
- El código correcto con más frecuencia. Un 29,4 % menos de errores que el modelo al que reemplaza, medido en tráfico transfronterizo real.
- Diseñado para datos de producto escasos. Orientamos la reconstrucción a descripciones breves e incompletas, que es la mayor parte de lo que aporta un envío postal y una parte mayor de un catálogo de comercio electrónico de lo que la mayoría de los comerciantes espera.
- Menos sorpresas en la frontera. Menos códigos incorrectos significa menos envíos que llegan con una factura de aranceles que nadie esperaba.
- Nada que cambiar por su parte. El nuevo modelo ya está realizando clasificaciones. Si hoy llama a Classify Zonos AI, su solicitud y la respuesta que recibe siguen siendo las mismas, así que no hay trabajo de integración que hacer ni ninguna configuración que activar.
Medido en dos semanas de tráfico transfronterizo real y en una comparación de 1.000 envíos frente a un competidor líder. La precisión de la clasificación varía según la categoría de producto y el nivel de detalle de la descripción del artículo.
El nuevo modelo de Classify de Zonos comete un 29,4 % menos de errores de clasificación
Cada paquete que cruza una frontera necesita un código SA, y ese código determina lo que debe pagar el envío y con qué fluidez avanza. Zonos lleva más de 16 años trabajando en ese problema, y Zonos Classify Zonos AI lo resuelve con modelos de IA propios que desarrollamos nosotros mismos.
Entrenamos nuestros modelos con datos transfronterizos que vemos de primera mano y los probamos nosotros mismos, en lugar de usar un modelo de propósito general con una instrucción aduanera añadida encima.
Ese trabajo nos ha mantenido a la cabeza. Frente al clasificador de un competidor líder, con los mismos 1.000 envíos, el modelo que Classify Zonos AI utiliza hoy comete un 33 % menos de errores.
Ahora lo hemos reconstruido para que sea aún mejor. En dos semanas de tráfico transfronterizo real, el nuevo modelo comete un 29,4 % menos de errores de clasificación que el modelo al que reemplaza. Ya está disponible.