Porque reconstruímos um modelo que já estava na liderança
Os nossos modelos anteriores foram afinados a fundo para o ecommerce, e essa afinação resultou.
O que continuava a surgir, tanto no ecommerce como no setor postal, era a escassez de informação com que muitas vezes temos de trabalhar. Um anúncio de ecommerce pode incluir um título descritivo, uma categoria e alguma indicação sobre o material de que o artigo é feito. Muitos incluem. Muitos outros são apenas uma marca e um nome de produto, e um anúncio chamado Summit Ridge Mid não indica se se trata de uma bota de caminhada, de uma mochila ou de um casaco, e muito menos de que é feito.
É no setor postal que isto se torna mais difícil. A Zonos processa a grande maioria de todos os envios postais que entram nos Estados Unidos, e aí uma encomenda é frequentemente descrita em duas ou três palavras, escritas num formulário aduaneiro pela pessoa que embalou a caixa, sem mais nada por trás.
Foi para isso que reconstruímos o modelo: para os artigos cuja descrição pouco diz, seja qual for o canal por onde chegam.
"T-shirt" pode corresponder a mais de 16 códigos HS - mas a qual?
Imagine que uma declaração indica t-shirt e nada mais. Pode tratar-se de qualquer um de mais de 16 códigos HS. O código correto depende do material da T-shirt, do público a que se destina o corte e da forma como a malha foi tricotada, e os direitos devidos variam com cada uma dessas respostas. Só o algodão e as fibras sintéticas ou artificiais já se enquadram em subposições diferentes, com taxas significativamente distintas.
Multiplique isso por um catálogo inteiro. Kid-Silk Mohair 25g é o tipo de título que vemos todos os dias, e mesmo assim tem de corresponder a uma única linha da pauta aduaneira.
Foram esses casos mais complicados o foco desta ronda. Os artigos bem descritos recebem a mesma atenção; simplesmente é menos provável que induzam um classificador em erro.
Como o medimos
Medimos o novo modelo da forma como gostaríamos que um fornecedor medisse por nós: em tráfego real, e não num conjunto de teste escolhido por nós. Utilizámos duas semanas de pedidos de classificação que passaram pela nossa plataforma, ou seja, os títulos e as descrições que os nossos clientes efetivamente enviam, incluindo aqueles que mal chegam a ser uma descrição.
Nesse tráfego, o novo modelo comete 29,4% menos erros do que o modelo que substitui.
Trata-se de um modelo novo, e não de uma versão reajustada do anterior. Reconstruímos o corpus com que aprende, treinando-o com decisões aduaneiras oficiais a par de milhões de anúncios parcialmente descritos que o nosso classificador vê todos os dias.
Face a um concorrente, nos mesmos envios
Comparar um modelo com o seu próprio modelo anterior só diz até certo ponto. Pegámos em 1.000 envios reais e passámo-los por três sistemas: o classificador de um concorrente líder, o modelo que o Classify Zonos AI utiliza atualmente e o novo. Todos os envios foram avaliados da mesma forma.
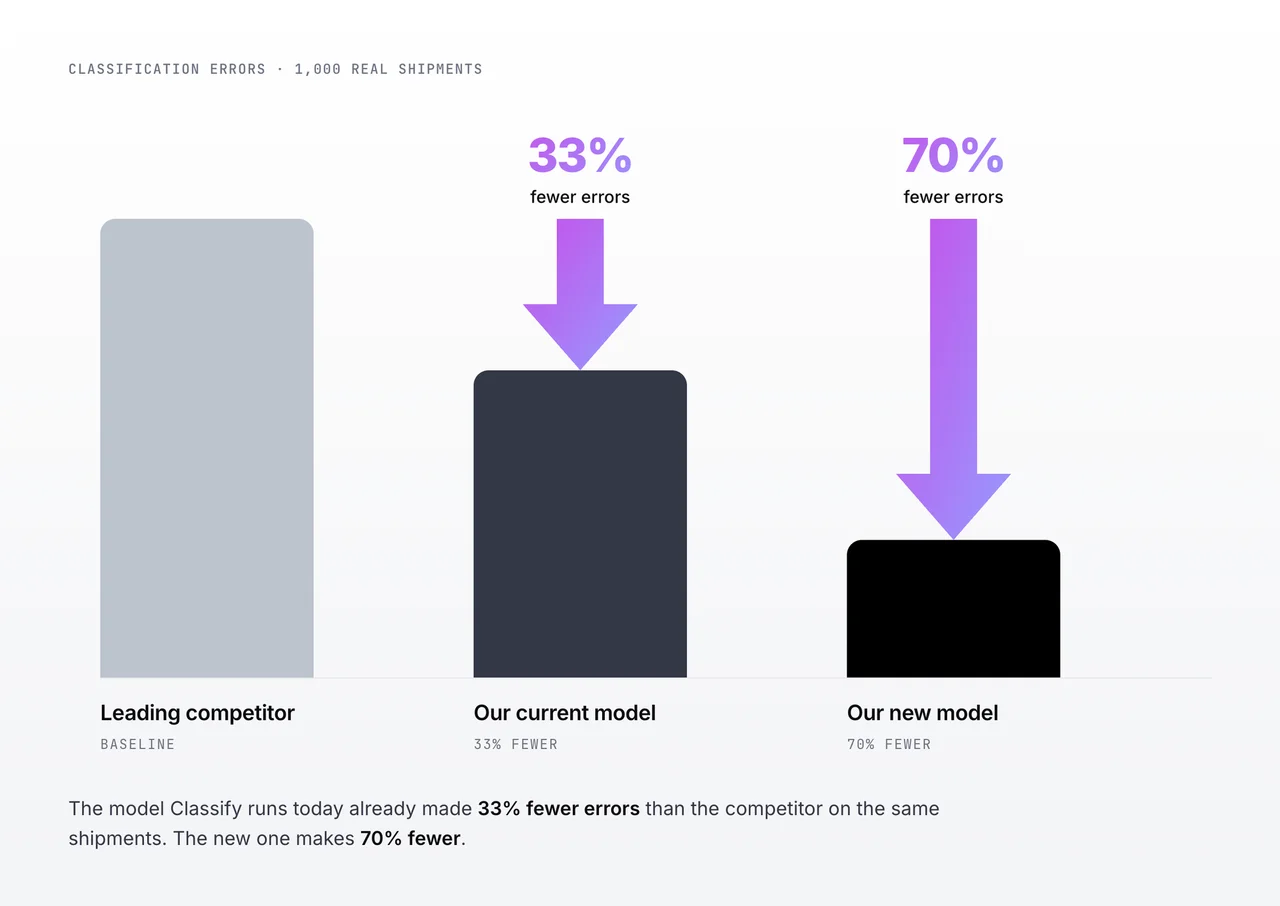
O modelo que o Classify Zonos AI utiliza atualmente já cometia 33% menos erros do que o concorrente. O novo comete 70% menos.
Alguns erros custam mais do que outros
Nem todos os erros de classificação têm o mesmo custo. Se um par de meias for classificado numa subposição ao lado daquela a que pertence, os direitos devidos costumam ser semelhantes e ninguém dá por isso. Se essas mesmas meias acabarem num capítulo completamente diferente da pauta aduaneira, registadas como algo que não são, os direitos já não são nada semelhantes. São esses os erros que se transformam numa fatura inesperada mais tarde, e são uma grande parte da razão pela qual reconstruímos o modelo.
O que isto significa para si
- O código correto com mais frequência. 29,4% menos erros do que o modelo que substitui, medidos em tráfego transfronteiriço real.
- Concebido para dados de produto escassos. Direcionámos a reconstrução para descrições curtas e incompletas, que são a maior parte do que um envio postal fornece e uma parte maior de um catálogo de ecommerce do que a maioria dos comerciantes imagina.
- Menos surpresas na fronteira. Menos códigos errados significam menos envios que chegam com uma fatura de direitos que ninguém esperava.
- Nada a alterar do seu lado. O novo modelo já está a fornecer classificações. Se utiliza o Classify Zonos AI atualmente, o seu pedido e a resposta que recebe mantêm-se iguais, pelo que não há trabalho de integração a fazer nem qualquer definição a ativar.
Medido em duas semanas de tráfego transfronteiriço real e numa comparação de 1.000 envios com um concorrente líder. A precisão da classificação varia consoante a categoria do produto e o nível de detalhe da descrição do artigo.
O novo modelo do Classify da Zonos comete 29,4% menos erros de classificação
Cada encomenda que atravessa uma fronteira precisa de um código HS, e esse código determina quanto o envio tem de pagar e com que fluidez circula. A Zonos dedica-se a este problema há mais de 16 anos, e o Zonos Classify Zonos AI resolve-o com modelos de IA proprietários que nós próprios desenvolvemos.
Treinamos os nossos modelos com dados transfronteiriços que observamos em primeira mão e testamo-los nós próprios, em vez de utilizarmos um modelo de uso geral com um prompt aduaneiro acrescentado.
Esse trabalho manteve-nos na liderança. Face ao classificador de um concorrente líder, nos mesmos 1.000 envios, o modelo que o Classify Zonos AI utiliza atualmente comete 33% menos erros.
Agora reconstruímo-lo para ser ainda melhor. Ao longo de duas semanas de tráfego transfronteiriço real, o novo modelo comete 29,4% menos erros de classificação do que o modelo que substitui. Já está em funcionamento.