为什么要重建一个本已领先的模型
我们之前的模型针对电商场景进行了深度调优,而且这些调优确实有效。
然而,无论是在电商端还是邮政端,反复出现的问题是:我们能掌握的信息往往少之又少。电商商品信息可能附带描述性标题、类别,以及商品材质等信息。很多商品确实如此。但还有更多商品只有一个品牌名和产品名,一个名为 Summit Ridge Mid 的商品,根本无法告诉你它是登山靴、背包还是夹克,更不用说它是用什么材料制成的了。
邮政渠道是最困难的。Zonos 处理着进入美国的绝大多数邮政货件,而这些包裹往往只用两三个词来描述,由打包的人填写在海关申报单上,除此之外再无其他信息。
这正是我们此次重建的目标:无论来自哪个渠道,那些描述信息不足的商品。
“T恤”可能对应 16 个以上的 HS 编码——究竟是哪一个?
假设一份申报单上只写着 t-shirt,别无其他。它可能对应 16 个以上的 HS 编码中的任何一个。正确的编码取决于这件T恤的材质、面向的穿着人群以及针织方式,而应缴税费会随着每一个答案而变化。仅棉质与化学纤维两类,就分属不同的子目,税率差异显著。
再把这一问题放大到整个商品目录。Kid-Silk Mohair 25g 这样的标题我们每天都会看到,而它最终仍必须对应到关税税则中的某一行。
这一轮我们重点攻克的正是这些棘手的商品。描述完整的商品同样得到了重视,只是它们不太容易难倒分类器。
我们如何进行衡量
我们以希望供应商为我们衡量的方式来衡量新模型:基于真实流量,而不是我们自己挑选的测试集。我们使用了平台上两周内的分类请求,也就是客户实际发送的标题和描述,包括那些几乎算不上描述的内容。
在这些流量中,新模型的错误比其所替代的模型减少了 29.4%。
这是一个全新的模型,而不是对旧模型的重新调优。我们重建了它的学习语料库,将官方海关裁定与我们的分类器每天看到的数百万条描述不完整的商品信息一起用于训练。
与竞争对手在相同货件上的对比
将模型与自家的旧模型进行比较,能说明的问题有限。我们选取了 1,000 票真实货件,分别在三个系统中运行:一家领先竞争对手的分类器、Classify Zonos AI 目前使用的模型,以及新模型。每票货件都采用相同的方式评分。
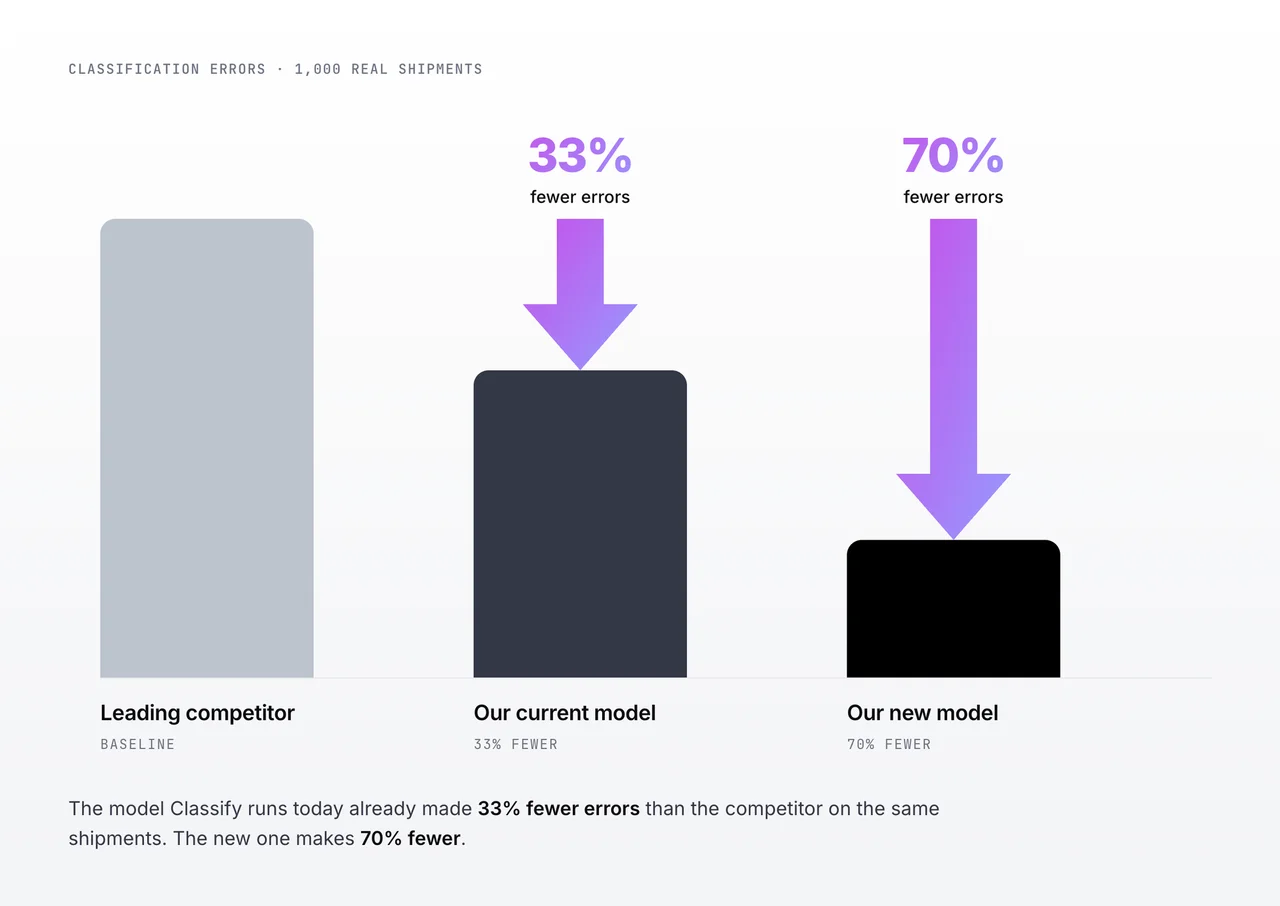
Classify Zonos AI 目前运行的模型错误已比竞争对手减少 33%。新模型则减少了 70%。
有些错误的代价更高
并非每个分类错误的代价都相同。如果一双袜子被归入与正确位置仅相差一个子目的编码,应缴税费通常相差无几,也不会有人注意到。但如果同样的袜子被归入关税税则中完全不同的章节,被当作其他商品申报,税费就会相差甚远。正是这些错误会在日后变成意料之外的账单,这也是我们重建模型的重要原因之一。
这对您意味着什么
- 更常获得正确的编码。 在真实跨境流量中测得,错误比其所替代的模型减少 29.4%。
- 专为信息有限的商品数据打造。 我们将此次重建聚焦于简短、不完整的描述,这正是邮政货件所能提供的大部分信息,在电商商品目录中所占比例也超出大多数商家的预期。
- 减少清关时的意外。 错误编码越少,意味着带着意外税费账单抵达的货件越少。
- 您无需做任何更改。 新模型已开始提供分类服务。如果您目前正在调用 Classify Zonos AI,您的请求和返回的响应都保持不变,因此无需任何集成工作,也无需开启任何设置。
基于两周真实跨境流量以及与一家领先竞争对手进行的 1,000 票货件对比测得。分类准确率因商品类别及商品描述的详细程度而异。
Zonos 全新 Classify 模型将分类错误减少 29.4%
每一个跨境包裹都需要一个 HS 编码,而这个编码决定了货物应缴纳多少税费,以及能否顺利通关。Zonos 在这一问题上已深耕 16 年以上,Zonos Classify Zonos AI 依靠我们自主构建的专有 AI 模型来解决它。
我们使用亲眼所见的跨境数据训练模型,并亲自进行测试,而不是在通用模型上简单套用一段海关提示词。
正是这些工作让我们保持领先。在相同的 1,000 票货件上,与一家领先竞争对手的分类器相比,Classify Zonos AI 目前运行的模型错误减少了 33%。
现在,我们对它进行了重建,使其更加出色。在为期两周的真实跨境流量中,新模型的分类错误比其所替代的模型减少了 29.4%。新模型现已上线。