為何重建一個已經領先的模型
我們以往的模型針對電子商貿進行了深度調校,而這些調校確實奏效。
然而,無論是電子商貿還是郵政方面,我們一再發現可用的資料往往少得可憐。一個電子商貿商品頁面可能附有描述性標題、類別,以及商品物料的相關資訊。不少商品頁面確實如此,但更多只有一個品牌名稱和產品名稱。一個名為 Summit Ridge Mid 的商品頁面,根本無法告訴你它是行山靴、背囊還是外套,更遑論它的物料。
郵政方面的情況最為困難。進入美國的郵政貨件中,絕大部分由 Zonos 處理,而這些包裹往往只以兩三個字描述,由包裝貨品的人填寫在海關申報表上,除此之外再無其他資料。
這正是我們重建模型的目標:無論經由哪個渠道,處理那些描述提供資訊不多的商品。
「T 恤」可對應 16 個以上的 HS 編碼——但到底是哪一個?
假設一份申報只寫著 t-shirt,別無其他。這可能對應 16 個以上的 HS 編碼。正確的編碼取決於 T 恤的物料、剪裁對象及針織方式,而應繳關稅會隨每個答案而改變。單是棉質與人造纖維,便已分屬不同子目,稅率差異相當大。
再將這個問題乘以整個商品目錄。Kid-Silk Mohair 25g 這類標題我們每天都會見到,但它仍然必須對應到稅則表中的其中一行。
這些較棘手的商品正是我們今次的重點。描述完善的商品同樣獲得重視,只是它們較少會難倒分類器。
我們如何衡量
我們以希望供應商為我們衡量的方式來評估新模型:採用實際流量,而非我們自選的測試集。我們使用了兩星期內經由我們平台處理的分類請求,即客戶實際傳送的標題和描述,包括那些幾乎稱不上是描述的內容。
在這些流量中,新模型的錯誤比所取代的模型少 29.4%。
這是一個全新的模型,而非舊模型的重新調校版本。我們重建了它所學習的語料庫,以官方海關裁定,以及我們的分類器每天處理的數以百萬計描述不完整的商品頁面作為訓練數據。
在相同貨件上與競爭對手比較
將模型與自家舊模型比較,所能說明的有限。我們取了 1,000 件真實貨件,並以三個系統處理:一家領先競爭對手的分類器、Classify Zonos AI 目前使用的模型,以及新模型。每件貨件均以相同方式評分。
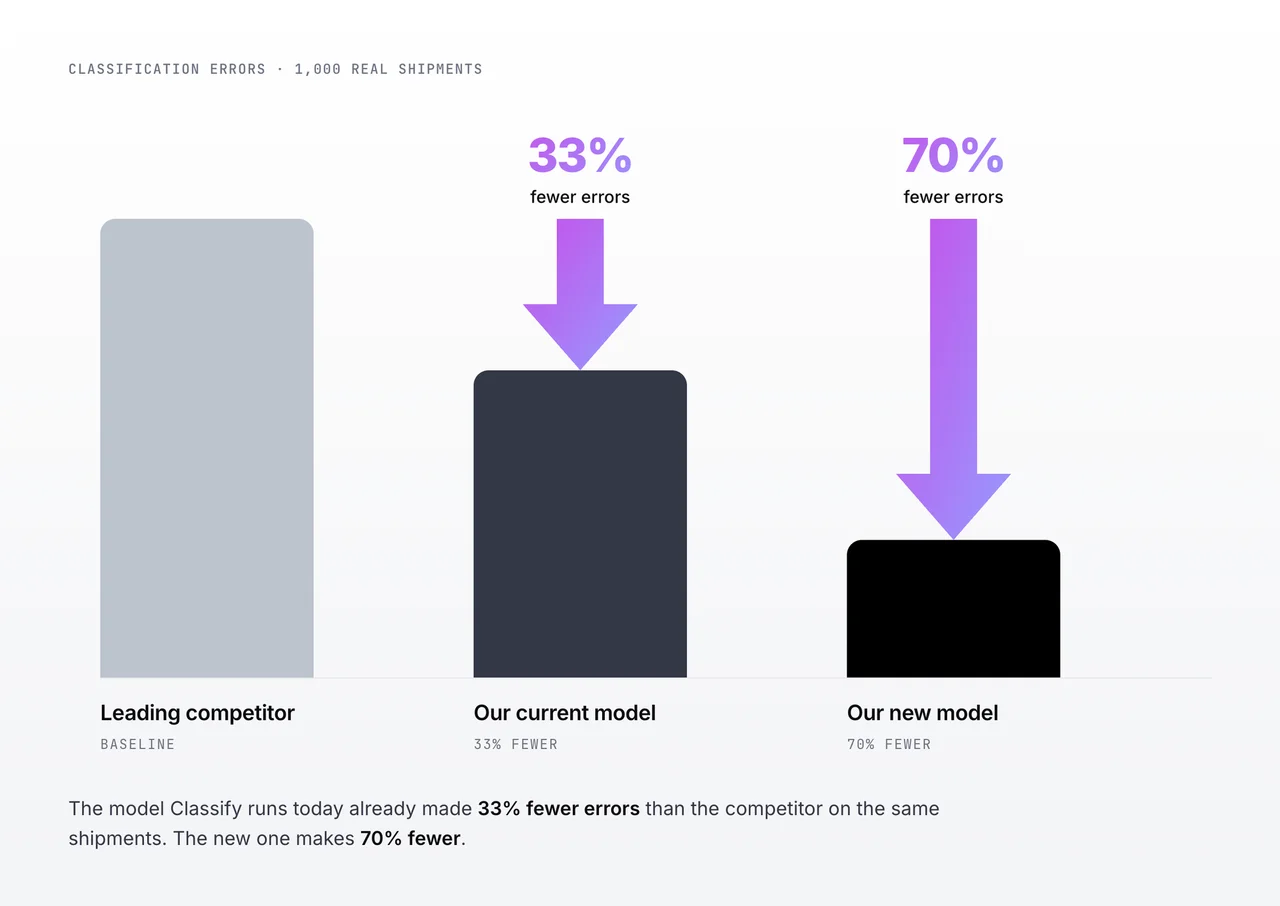
Classify Zonos AI 目前運行的模型,錯誤已比競爭對手少 33%。新模型則少 70%。
有些錯誤的代價更高
並非每個分類錯誤都帶來相同的賬單。如果一對襪子被歸入與正確位置只差一個子目的類別,應繳關稅通常相差不遠,也沒有人會察覺。但如果同一對襪子被歸入稅則表中完全不同的章節,被當作另一種商品申報,關稅便會相差甚遠。這些錯誤日後會變成意料之外的賬單,也是我們重建模型的重要原因之一。
這對你有何意義
- 更常得出正確編碼。 以實際跨境流量衡量,錯誤比所取代的模型少 29.4%。
- 專為資料不足的產品而設。 我們重建模型時針對簡短、不完整的描述,這正是郵政貨件提供的大部分資料,而在電子商貿商品目錄中所佔的比例也比大多數商戶預期的高。
- 邊境上的意外更少。 錯誤編碼減少,意味著帶著意料之外關稅賬單抵達的貨件也更少。
- 你無須作任何改動。 新模型已在提供分類服務。如果你現時調用 Classify Zonos AI,你的請求和收到的回應都保持不變,因此無須進行任何整合工作,也無須開啟任何設定。
以兩星期的實際跨境流量,以及與一家領先競爭對手進行的 1,000 件貨件比較作衡量。分類準確度會因產品類別及商品描述的詳細程度而有所不同。
Zonos 全新 Classify 模型的分類錯誤減少 29.4%
每件跨境包裹都需要一個 HS 編碼,而這個編碼決定了貨件須繳付多少稅費,以及通關是否順暢。Zonos 在這個問題上已投入超過 16 年,而 Zonos Classify Zonos AI 則以我們自行開發的專有 AI 模型解決這個問題。
我們以親身接觸的跨境數據訓練模型,並自行測試,而不是在通用模型上硬加一段海關提示詞了事。
正是這些工作讓我們一直保持領先。在相同的 1,000 件貨件上,與一家領先競爭對手的分類器相比,Classify Zonos AI 目前運行的模型錯誤少 33%。
現在,我們重建了模型,令它更上一層樓。在兩星期的實際跨境流量中,新模型的分類錯誤比所取代的模型少 29.4%。新模型現已上線。