Por que reconstruímos um modelo que já estava à frente
Nossos modelos anteriores foram ajustados a fundo para o ecommerce, e esse ajuste funcionou.
O que continuava aparecendo, tanto no ecommerce quanto no setor postal, era o quão pouco muitas vezes temos para trabalhar. Um anúncio de ecommerce pode vir com um título descritivo, uma categoria e alguma informação sobre o material do item. Muitos vêm assim. Muitos outros trazem apenas uma marca e um nome de produto, e um anúncio chamado Summit Ridge Mid não diz se é uma bota de caminhada, uma mochila ou uma jaqueta, muito menos de que material é feito.
O setor postal é onde isso fica mais difícil. A Zonos processa a grande maioria de todas as remessas postais que entram nos Estados Unidos, e um pacote ali costuma ser descrito em duas ou três palavras, digitadas em um formulário aduaneiro pela pessoa que embalou a caixa, sem mais nada por trás.
Foi para isso que reconstruímos o modelo: os itens cuja descrição diz pouco, seja qual for o canal pelo qual chegam.
"Camiseta" pode corresponder a mais de 16 códigos HS - mas qual deles?
Digamos que uma declaração diga t-shirt e nada mais. Isso poderia ser qualquer um de mais de 16 códigos HS. O código correto depende do material da camiseta, do público para o qual ela é cortada e de como foi tricotada, e o imposto devido muda com cada uma dessas respostas. Só o algodão e as fibras sintéticas ou artificiais já ficam em subposições diferentes, com alíquotas significativamente distintas.
Multiplique isso por um catálogo inteiro. Kid-Silk Mohair 25g é o tipo de título que vemos o dia todo, e ele ainda precisa resultar em uma única linha da tabela tarifária.
Esses casos mais complicados foram o foco desta rodada. Os itens bem descritos recebem a mesma atenção; eles apenas têm menos probabilidade de confundir um classificador.
Como medimos
Medimos o novo modelo da forma como gostaríamos que um fornecedor medisse para nós: em tráfego real, e não em um conjunto de teste escolhido por nós. Usamos duas semanas de solicitações de classificação que passaram pela nossa plataforma, ou seja, os títulos e descrições que nossos clientes realmente enviam, incluindo aqueles que mal chegam a ser uma descrição.
Nesse tráfego, o novo modelo comete 29,4% menos erros do que o modelo que ele substitui.
Este é um modelo novo, e não uma versão reajustada do antigo. Reconstruímos o corpus com o qual ele aprende, treinando-o com decisões aduaneiras oficiais junto com milhões dos anúncios parcialmente descritos que nosso classificador vê todos os dias.
Contra um concorrente, nas mesmas remessas
Comparar um modelo com o seu próprio modelo mais antigo só diz até certo ponto. Pegamos 1.000 remessas reais e as submetemos a três sistemas: o classificador de um concorrente líder, o modelo que o Classify Zonos AI usa hoje e o novo. Todas as remessas foram avaliadas da mesma forma.
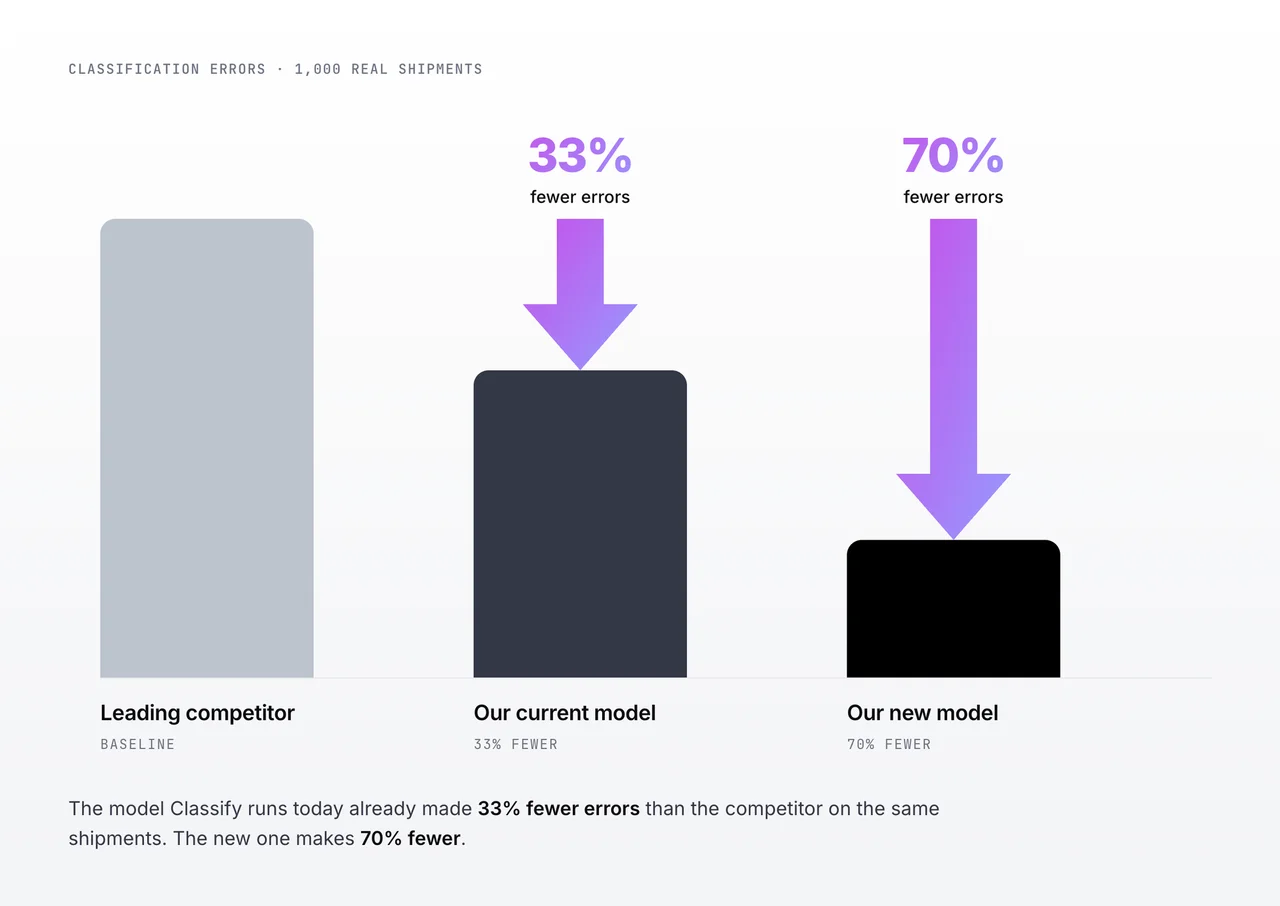
O modelo que o Classify Zonos AI usa hoje já cometia 33% menos erros do que o concorrente. O novo comete 70% menos.
Alguns erros custam mais do que outros
Nem todo erro de classificação gera a mesma conta. Se um par de meias for classificado uma subposição ao lado de onde deveria estar, o imposto devido geralmente é parecido, e ninguém percebe. Se essas mesmas meias acabarem em um capítulo totalmente diferente da tabela tarifária, registradas como algo que não são, o imposto não será nada parecido. São esses erros que se transformam em uma cobrança inesperada mais tarde, e eles são uma grande parte do motivo pelo qual reconstruímos o modelo.
O que isso significa para você
- O código correto com mais frequência. 29,4% menos erros do que o modelo que ele substitui, medidos em tráfego transfronteiriço real.
- Feito para dados de produto escassos. Direcionamos a reconstrução para descrições curtas e incompletas, que são a maior parte do que uma remessa postal oferece e uma parcela maior de um catálogo de ecommerce do que a maioria dos lojistas imagina.
- Menos surpresas na fronteira. Menos códigos errados significam menos remessas que chegam com uma cobrança de impostos que ninguém esperava.
- Nada a mudar do seu lado. O novo modelo já está fornecendo classificações. Se você chama o Classify Zonos AI hoje, sua solicitação e a resposta que você recebe continuam as mesmas, então não há trabalho de integração a fazer nem configuração a ativar.
Medido em duas semanas de tráfego transfronteiriço real e em uma comparação de 1.000 remessas com um concorrente líder. A precisão da classificação varia conforme a categoria do produto e o nível de detalhe da descrição do item.
O novo modelo do Zonos Classify comete 29,4% menos erros de classificação
Todo pacote que cruza uma fronteira precisa de um código HS, e esse código determina quanto a remessa deve pagar e com que facilidade ela avança. A Zonos se dedica a esse problema há mais de 16 anos, e o Zonos Classify Zonos AI o resolve com modelos de IA proprietários que nós mesmos construímos.
Treinamos nossos modelos com dados transfronteiriços que observamos em primeira mão e os testamos nós mesmos, em vez de usar um modelo de uso geral com um prompt aduaneiro acoplado.
Esse trabalho nos manteve à frente. Em comparação com o classificador de um concorrente líder, nas mesmas 1.000 remessas, o modelo que o Classify Zonos AI usa hoje comete 33% menos erros.
Agora nós o reconstruímos para ser ainda melhor. Ao longo de duas semanas de tráfego transfronteiriço real, o novo modelo comete 29,4% menos erros de classificação do que o modelo que ele substitui. Ele já está em funcionamento.